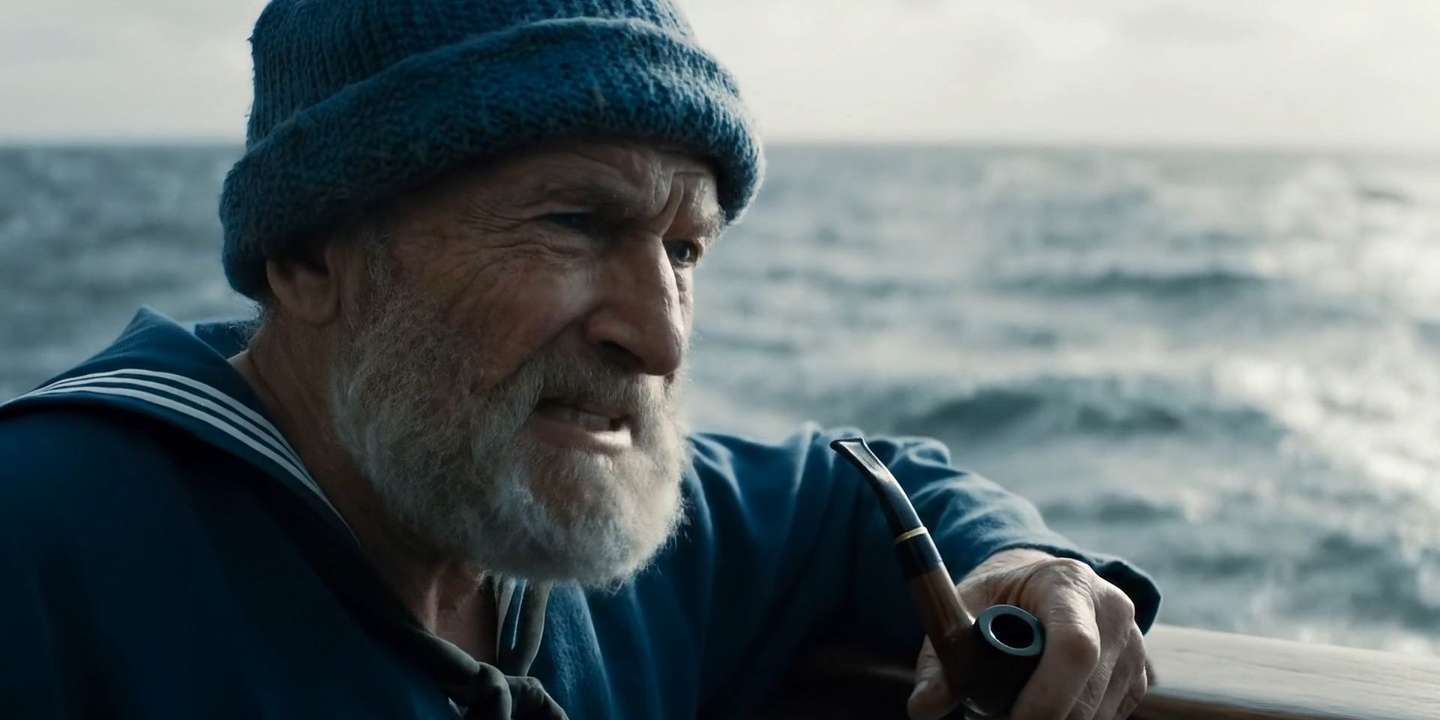

Mais realista, com som ambiente e diálogos incluídos. A Google tem um novo modelo de inteligência artificial (IA) para gerar vídeo, o Veo 3, com a particularidade de já ter também a componente áudio incluída. A inclusão de áudio, seja para som ambiente ou para movimentos, como passos, por exemplo, é uma das diferenças em relação à geração anterior — até aqui, o antecessor Veo 2 já gerava vídeo, mas sem som.
A 20 de maio, na conferência anual I/O, a Google mostrou pequenos excertos de vídeos criados com o Veo 3, uma ferramenta que, a partir de texto consegue criar um vídeo. Mas há uma diferença entre apenas ver um exemplo de vídeo gerado com IA ou perceber como é que se comporta na realidade.
É o que vários académicos e entusiastas da inteligência artificial têm estado a fazer desde que o Veo 3 foi lançado. Há vídeos online das experiências, desde simulações de noticiários, exposições automóveis fictícias ou até anúncios publicitários. No ecrã, até podem parecer pessoas e cenários reais, mas não são.
I did more tests with Google's #Veo3. Imagine if AI characters became aware they were living in a simulation! pic.twitter.com/nhbrNQMtqv
— Hashem Al-Ghaili (@HashemGhaili) May 21, 2025
PJ Accetturo já andou a testar as capacidades do Veo 3. Numa publicação no X, o realizador de filmes com IA publicou um anúncio a um medicamento inventado. Accetturo é norte-americano e começou por trabalhar em publicidade, mas passa agora mais tempo a experimentar modelos de IA e a perceber como podem ser usados no entretenimento. No ano passado, um dos vídeos que fez com IA tornou-se viral: um trailer do filme “A Princesa Mononoke”, que foi amplamente criticado.
I made this trailer because I wanted to explore this world for myself, for fun. I'm not saying it's fully photorealistic, but we're getting closer. And we should talk about that.
It's important that we have this conversation. We can't put gen AI back in Pandora's box. pic.twitter.com/x9YEX6tGLl
— PJ Ace (@PJaccetturo) October 8, 2024
“Costumava gravar anúncios farmacêuticos de 500 mil dólares. Fiz isto com 500 dólares em créditos do Veo 3 em menos de um dia”, resumiu sobre a experiência com este modelo de geração de vídeo. Uma subscrição de um modelo de IA tem um determinado número de créditos previstos — e cada pedido consome uma determinada quantidade de créditos. Ao Observador, PJ Accetturo descreve o modelo como “uma mudança de paradigma”, mas também reconhece que ainda tem vários desafios e limitações.
I used to shoot $500k pharmaceutical commercials.
I made this for $500 in Veo 3 credits in less than a day.
What’s the argument for spending $500K now?
(Steal my prompt below ????????) pic.twitter.com/4UH43EXDux
— PJ Ace (@PJaccetturo) May 22, 2025
“É uma mudança só pela questão de ser simples e de ter tudo concentrado num único sítio. Por exemplo, antes tinha de usar o Midjourney para as imagens, o Kling para as animações, o ElevenLabs para as vozes, Runway e quatro outros programas para fazer upscalling [aumentar a resolução dos resultados recebidos].” Com este novo modelo, há uma concentração das tarefas. “Escrevo um texto e recebo personagens a falar”, resume. Já não são necessários vários programas.
Até parece fácil. Na realidade, quem já interagiu com um modelo deste género, sabe que podem ser necessárias muitas tentativas para atingir o objetivo pretendido. Qualquer prompt [pedido] precisa de muito trabalho e um texto detalhado para conseguir um resultado aceitável. Com a Google a sugerir que seja usado nas indústrias de publicidade e entretenimento, ainda mais detalhes são precisos num prompt, como tipo de plano, cores, descrição das personagens, entre outros detalhes.
PJ Accetturo já encontrou vários erros a usar o modelo. “Honestamente, há muitos bugs [erros]. A funcionalidade chamada frames para vídeo [de ter imagens de referência e gerar animações a partir daí] não funciona. [O modelo] está basicamente limitado à função de texto para vídeo, que funciona bem e é impressionante”, contextualiza.
[A polícia é chamada a uma casa após uma queixa por ruído. Quando chegam, os agentes encontram uma festa de aniversário de arromba. Mas o aniversariante, José Valbom, desapareceu. “O Zé faz 25” é o primeiro podcast de ficção do Observador, co-produzido pela Coyote Vadio e com as vozes de Tiago Teotónio Pereira, Sara Matos, Madalena Almeida, Cristovão Campos, Vicente Wallenstein, Beatriz Godinho, José Raposo e Carla Maciel. Pode ouvir o 2.º episódio no site do Observador, na Apple Podcasts, no Spotify e no Youtube Music. E o primeiro episódio aqui.]

Além disso, vê margem para evolução do ponto de vista do áudio, considerando que a “qualidade do áudio é bastante pobre”. “Não há consistência entre as vozes e as imagens que são geradas”, explica. Por exemplo, o modelo pode gerar um resultado em que o diálogo não acompanha os movimentos da boca da personagem. A própria Google assume que ainda há trabalho a fazer neste campo. “Estamos continuamente a trabalhar para refinar a sincronização de áudio e eliminar questões de discurso incoerente”, é possível ler na descrição do Veo 3.
Este criador de conteúdos também aponta falhas a uma questão fulcral: o preço. “É muito caro, são três dólares por shot”, exemplifica. O Veo 3 está limitado a alguns mercados — não está disponível em Portugal nem em nenhum outro país da União Europeia. E, nos mercados onde está acessível, acarreta a subscrição mais dispendiosa de um plano da Google: a Ultra, que custa cerca de 250 dólares por mês.
O Observador questionou a Google sobre a ausência do modelo em Portugal e noutros Estados-membros da União Europeia. “Inicialmente anunciamos nos Estados Unidos, mas no dia 24 já anunciamos mais países e esperamos, muito em breve, lançar [o modelo] noutros países”, diz fonte oficial, remetendo para a lista de disponibilidades de 70 países. O modelo Ultra também não está, por agora, disponível em Portugal. Sobre essa disponibilidade, a Google refere que “em breve também chegará a mais países”, sem mais detalhes.
Veo 3 dropped about 100 hours ago, and it's been on ???????????? ever since
Now, we’re excited to announce:
+ 71 new countries have access
+ Pro subscribers get a trial pack of Veo 3 on the web (mobile soon)
+ Ultra subscribers get the highest # of Veo 3 gens w/ refreshesHow to try… pic.twitter.com/AJGpo8KKpP
— Josh Woodward (@joshwoodward) May 24, 2025
Atualmente, em Portugal está disponível apenas o modelo de subscrição Pro da Google, que inclui, entre outras funções, o acesso ao antecessor do Veo 3, o Veo 2.
Um modelo que trabalha a partir de ruído e que ainda tem margem para evoluir
O Veo 3 é um exemplo de um modelo de difusão, explica ao Observador João Magalhães, professor do Departamento de Ciências da Computação da Nova FCT. Ou seja, “começa a [trabalhar] a partir de ruído, que é completamente aleatório”. Todos os modelos de difusão são treinados “com várias fontes de dados, visuais e de áudio”, acrescenta.
A partir daí, parte desse princípio para “progressivamente ir melhorando [a partir do ruído] até obter uma imagem, um vídeo com aquela qualidade final”. Em comparação com a geração anterior, o Veo 3 “acima de tudo” evoluiu “na qualidade visual do vídeo final”.
“Há dois ou três anos” que João Magalhães está envolvido num projeto de colaboração com a Google para investigação nesta tecnologia de difusão. Os investigadores da Nova FCT tentam superar os desafios que esta tecnologia tem e desenvolvem artigos em colaboração com a divisão Google Research. Nesse sentido, refere que ainda há margem para que modelos deste género evoluam.
“O Veo 3 está a um nível acima do que já tínhamos visto”, realça. Dá como exemplo a dificuldade de manter a coerência entre imagens. “Isso já está parcialmente mitigado, quando dou uma instrução ao modelo para gerar um vídeo de certa e determinada maneira, segue fielmente o que eu lhe digo para fazer”, exemplifica.
Um dos exemplos de vídeo divulgado pela Google, feito pelo modelo de IA
Outro ponto que é realçado neste modelo é o facto de parecer compreender mais regras da física e de movimento. João Magalhães também tem uma explicação para este desenvolvimento. “Os modelos anteriores focavam-se em gerar uma imagem e depois extrapolar essa imagem para um dado tipo de movimento.” Só que, como inicialmente os modelos eram treinados “só com imagens, que são paradas” não tiveram qualquer indicação sobre as leis da física. Era por isso que, em alguns casos, os exemplos de bugs destes modelos incluíam pássaros que voavam para trás ou um humano a correr numa passadeira ao contrário.
Agora, como alguns dos modelos de difusão “já são treinados com vídeo, essas leis da física são mais bem capturadas pelos modelos atuais do que pelos anteriores”. Dá alguns exemplos. “Como é que uma pena cai em comparação a como é que uma pedra cai. Ou perceber, por exemplo, que posso rasgar uma folha de papel mas não consigo rasgar uma folha de madeira.”
O casamento entre o áudio e o vídeo, concentrado num único modelo, também é a subida, por parte da Google, de um degrau “de um desafio grande”, diz João Magalhães. “Um dos aspetos em que nós, humanos, notamos maior diferença é no alinhar da fala com os lábios [da personagem gerada por IA]. É um desafio ainda bastante difícil, mas que está bastante melhor do que no passado.”
E, num panorama mais amplo de modelos de difusão, esta tecnologia ainda tem muito por onde se superar, diz João Magalhães. “Há o problema da consistência e das narrativas não lineares.” Por exemplo, “a cena seguinte depender de [ações que decorreram em] cenas anteriores”. “Se uma primeira cena tem uma dada personagem, na cena seguinte outra e mais à frente quero juntá-los numa cena diferente… isso ainda é difícil”, relata. Concretamente sobre o Veo 3, lembra que “uma das características nos vídeos [que circulam] é que têm praticamente sempre a mesma personagem.” Ou seja, ainda é uma das áreas com espaço para melhoria.
O fim “do ver para crer”? Que limites de segurança tem o modelo?
O debate sobre os riscos da IA não é novo e, cada vez que há um lançamento deste género levantam-se as preocupações sobre como conviver com imagens e vídeos artificiais e as implicações que acarreta para a desinformação.
João Magalhães, professor universitário, também já passou os olhos pelos vídeos que simulam noticiários. “Acho que é um problema verdadeiramente sério”, destaca. “Vamos imaginar que mesmo que desconfie da [veracidade de] um vídeo. Se [for IA] e enviar para, vá, todas as pessoas que conheço, se 10% delas acreditarem ainda são muitas pessoas. Que depois podem difundir esse vídeo por outras pessoas também”, exemplifica.
Porém, considera que “o problema não é necessariamente só deste tipo de algoritmo” de geração de imagem ou de vídeo. “Acho que é mesmo um problema das redes sociais e da propagação de informação falsa ou descontextualizada, porque temos inúmeros exemplos disso.” Até recorre a um exemplo da atualidade — como a Casa Branca usou imagens descontextualizadas da República Democrática do Congo para confrontar o Presidente da África do Sul e acusar o país de ter em curso um “genocídio branco”. “Acho que estes algoritmos são perigosos, mas não são mais perigosos do que este exemplo que eu acabei de referir.”
Às vezes, “não se necessita de algoritmo absolutamente nenhum”, basta “alguém mal intencionado”. Refere que “a questão engraçada é as pessoas falarem da IA e de que no futuro pode dominar o mundo. (…) O que me provoca receio é o que os humanos podem fazer com esses algoritmos, não é propriamente o algoritmo.” Defende a necessidade de “mais literacia digital das pessoas, de saberem em que entidades devem confiar para obter informação factual”.
Na descrição das capacidades do Veo 3, a Google dedica um campo à segurança e responsabilidade. “Bloqueamos pedidos e resultados perigosos e testamos como é que novas funcionalidades podem afetar a segurança”, diz a empresa. Além do bloqueio de pedidos, a tecnológica refere que “os vídeos feitos através do Veo são marcados com SynthID, a tecnologia para marcas de água e deteção de conteúdos gerados por IA”.
Em linhas gerais, estas marcas de água não são visíveis ao olho humano, mas podem ser detetadas pelas máquinas. Neste momento, a plataforma SynthID Detector, em que um utilizador poderá carregar uma imagem, vídeo, ficheiro de áudio ou texto, está ainda indisponível, sendo possível juntar-se à lista de espera para os testes iniciais. É de realçar que, segundo a empresa, só funcionará para detetar conteúdos gerados ou manipulados com tecnologia da própria empresa.
Vídeos, imagens e sons manipulados andam à solta na internet. Quem pode resolver? Os caça deepfakes